Stückliste: Projekte

Dreizehn End-to-End-Projekte: Agentensysteme und LLM-Workflows, Prognose, Machine Learning, NLP, Computer Vision, Reinforcement Learning und BI. Jede Kennzahl ist aus den verlinkten Repositories reproduzierbar oder online vorführbar; drei Projekte sind deployed.

Pos.BezeichnungKennzahlStackStatus
01Arkon Manufacturing AIML-Modelle 7XGBoost · PyTorch · n8n · Langflow · TableauLive
02KI-Agentensystem (AI-Brain)geplante Workflows 19Claude Code · Codex · n8n · PythonPrivat
03FreshMart Demand PlannerRMSE 138,0Python · MLflow · StreamlitDemo
04Predictive Maintenance: Flottenrisiko & KostenPR-AUC 0,902XGBoost · SHAP · SQLGitHub
05KI-AuftragstriageTreffer 30/30n8n · Gemini · AirtableGitHub
06Retail-KPI-DashboardMonate 48Tableau · LODLive
07Neuron Platformer RLErfolgsrate (Holdout) 80 %PyTorch · Stable-Baselines3GitHub
08FX Random Walk BenchmarkFehler erklärt r = 0,97Python · statsmodels · XGBoostGitHub
09CIFAR-10 Transfer-Learning-StudieAccuracy 82,7 %TensorFlow · ResNet50GitHub
10NLP: Disaster-Tweets-KlassifikationAccuracy 0,819scikit-learn · DistilBERTGitHub
11Car Price EstimatorMedianfehler 11,9 %Python · XGBoostGitHub
12IATF Quality Report Promptohne erfundene Zahlen 7/7Claude · Python stdlibGitHub
13TravelTide: KundensegmentierungNutzer 5.998SQL · DatabricksGitHub
Pos. 01 · Jul–Sep 2026 Live
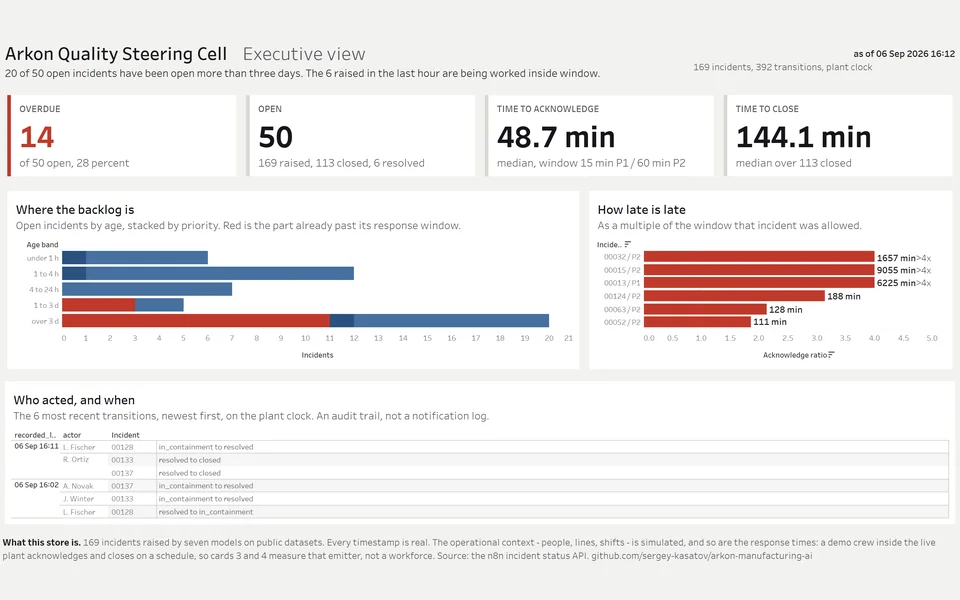
Screenshot der Executive-Ansicht der Arkon Quality Steering Cell auf Tableau Public, Stand 06.09.2026 16:12 Werksuhr: der Statussatz (20 von 50 offenen Vorfällen sind älter als drei Tage, die 6 der letzten Stunde werden innerhalb des Zeitfensters bearbeitet), vier KPI-Karten (überfällig 14 von 50 offenen, 28 Prozent; offen 50 bei 169 gemeldeten, 113 geschlossenen und 6 gelösten; Zeit bis zur Bestätigung 48,7 min Median gegen ein Zeitfenster von 15 min für P1 und 60 min für P2; Zeit bis zum Abschluss 144,1 min Median über 113 geschlossene), offene Vorfälle nach Altersband und Priorität mit dem überfälligen Anteil in Rot, die sechs langsamsten Bestätigungen als Vielfaches des jeweils erlaubten Zeitfensters und die sechs letzten Übergänge mit Bearbeiter
Abb. 01Executive-Ansicht auf Tableau Public, Stand 06.09.2026 16:12 · Aufnahme 06.09.2026

Arkon Manufacturing AI

Eine Industrie-4.0-Qualitätsplattform für einen fiktiven Hersteller der Schwerindustrie, auf einem NAS deployed und in Betrieb. Sieben Machine-Learning-Modelle auf echten öffentlichen Datensätzen (Restlebensdauer von Prüfstandsmotoren, Fehlerklassifikation einer Lkw-Flotte, vier Arten visueller Prüfung, ein Textmodell über Verbraucherbeschwerden) veröffentlichen ein einziges Risikoereignis mit zwölf Feldern, sodass nichts stromabwärts weiß, welches Modell gesprochen hat. Eine Quality Steering Cell auf n8n validiert den Vertrag, unterdrückt Wiederholungen, schreibt einen Append-only-Vorfallsspeicher, weist nach Abteilung zu und stellt bei P1 oder P2 einer namentlich benannten Person eine Telegram-Karte zu. Ein Streamlit-Cockpit ist die einzige Oberfläche, die einen Vorfall bewegt; ein Langflow-Assistent beantwortet das Warum aus zehn Dokumenten und dem Live-Speicher und übergibt dem Bediener ein ausgefülltes Formular, statt es selbst zu unterschreiben, sodass die Reaktionszeit-KPI weiterhin das Werk misst und nicht den Agenten. Zwei Agenten blicken in entgegengesetzte Richtungen: der Langflow-Assistent nach innen, ins Werk, und ein Customer Quality Desk auf n8n nach außen, zum Kunden, das einem OEM Auskunft zu einer Qualitätsmeldung anhand ihrer Referenz gibt. Sie treffen sich in genau einer Datei, und der Verkehr läuft nur in eine Richtung: acht kundensichere Felder zu einem Vorgang hinaus, kein Schreibzugriff zurück, davor ein Guardrail und dahinter ein Sanitizer. Ein Live-Emitter löst alle acht bis zwölf Minuten einen echten, neu terminierten Vorfall aus, und eine simulierte Schicht arbeitet ihn ab. Die Executive-Ansicht ist ein als XML generiertes Tableau-Workbook aus derselben Status-API, veröffentlicht auf Tableau Public.

ML-Modelle auf öffentlichen Datensätzen 7 KI-Agenten, in beide Richtungen 2 n8n-Workflows im Betrieb 12 Tests in CI 203
XGBoostPyTorchn8nLangflowStreamlitTableau

Beide Agenten waren bis zum 15. September 2026 als Live-Demos im Internet erreichbar, hinter einem Login und auf einem befristeten OpenRouter-Schlüssel, der Mitte September 2026 ausläuft. Beide öffentlichen Zugänge sind jetzt geschlossen; das README im Repository zeigt Screenshots beider Agenten im Einsatz, und die beiden Tableau-Ansichten brauchen gar keinen Schlüssel. Werk, Schicht und Vorfallsstrom sind simuliert und so gekennzeichnet; die Modelle, die Datensätze, jeder Zeitstempel und die Ebenen n8n, Langflow, Streamlit und Tableau sind echt.
Pos. 02 · seit Jun 2026
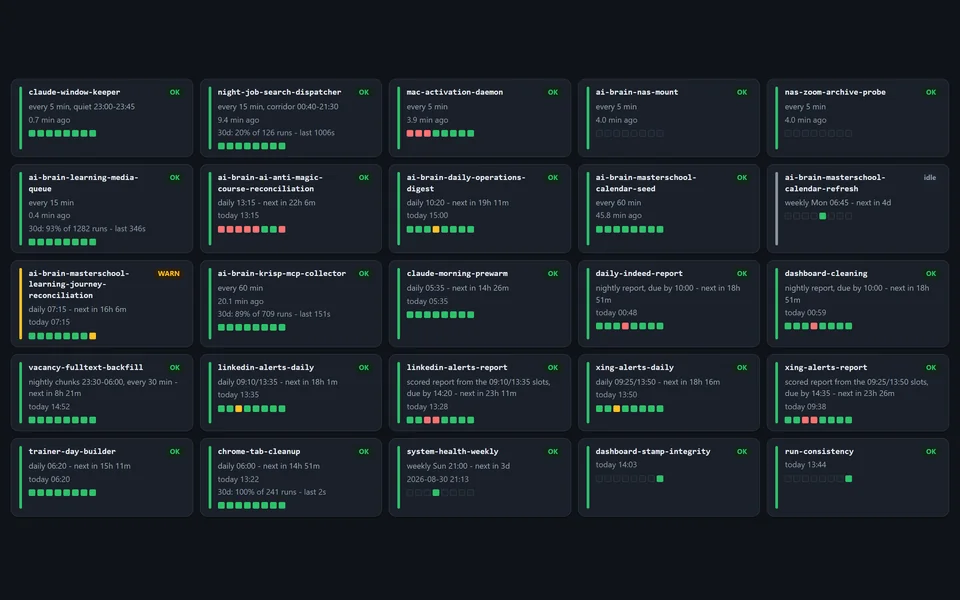
Screenshot des Vault Mission Control Boards, nur das Worker-Raster: 25 Kacheln mit Worker-Name, Zeitplan, letztem Lauf, 30-Tage-Historie und Status; WARN-Zustände so gezeigt, wie sie vorgefunden wurden
Abb. 02Mission Control, das Live-Statusboard · Aufnahme 03.09.2026

KI-Agentensystem (AI-Brain)

Eine Jobsuche, ein Vollzeit-Datenprogramm und mehrere private Verwaltungsbereiche erzeugen immer dieselbe Art wiederkehrender Arbeit: aus einer Quelle sammeln, gegen die Historie entdoppeln, jeden Eintrag bewerten, das Ergebnis in die richtige Datei schreiben und zwischen den Sitzungen nichts verlieren. Von Hand skaliert das nicht, und einem Chat-Assistenten alles zu überlassen scheitert anders: er hat kein Gedächtnis zwischen Sitzungen, wiederholt bereits erledigte Arbeit und liefert lieber eine plausible Antwort, als zu melden, dass er keine bekommen hat. Die Entwurfsfrage lautete deshalb nie "kann ein Agent das", sondern "wie verhindert man, dass er unbemerkt das Falsche tut". Die Antwort sind vier Regeln, aus denen alles Weitere folgt. Jeder wiederkehrende Job nennt genau einen geplanten Owner und genau einen kanonischen Ausgabepfad, weil mehrere Agenten dieselben Dateien ohne Datenbanksperre schreiben. Eine deterministische Python-Schicht übernimmt Abruf, Parsing, Entdopplung und Schreiben, und das Modell bekommt nur die Bewertung, die wirklich Bewertung erfordert. Prüf-Gates können einen Lauf scheitern lassen: eigene Checks prüfen, dass jede in einem Bericht behauptete Kennung in Registry und Archiv existiert, dass keine Zeichensatz-Korruption ausgeliefert wurde, dass erzeugte PDFs maschinenlesbar und in der richtigen Reihenfolge sind, dass kein Dokument eine Kompetenz behauptet, die die Quelldatei nicht führt, und dass der Text nicht nach Vorlage klingt. Und der Watchdog läuft auf einem Rechner, der nicht gemeinsam mit dem überwachten ausfallen kann, denn ein Watchdog mit gemeinsamem Schicksal meldet genau dann nichts, wenn es darauf ankommt. Das eigentliche Ergebnis sind die Fehlerbilder, und jedes wurde im Betrieb gefunden: erfundene Kennzahlen, als Interviewmaterial angeboten; ein schreibender Agent, der das Vokabular des Ausgangsdokuments in die Beschreibung des Kandidaten übernimmt; und die Klasse, die kein Gate erkennt, bei der eine dokumentierte Methode nicht über das Substantiv, sondern über das Verb aufgewertet wird. Letztere ist als benannte Grenze festgehalten, nicht als gelöstes Problem.

geplante Workflows 19 LLM-Laufzeiten auf einem Regelwerk 3 Prüf-Gates 5
Claude CodeCodexGeminin8nPythonlaunchd

Kein öffentliches Repository: das System betreibt einen privaten Wissensspeicher. Von mir entworfen, spezifiziert und betrieben; der Code entstand weitgehend KI-gestützt. Live per Bildschirmfreigabe vorführbar.

Pos. 03 · Apr–Mai 2026 Demo · startet in ca. 30 s
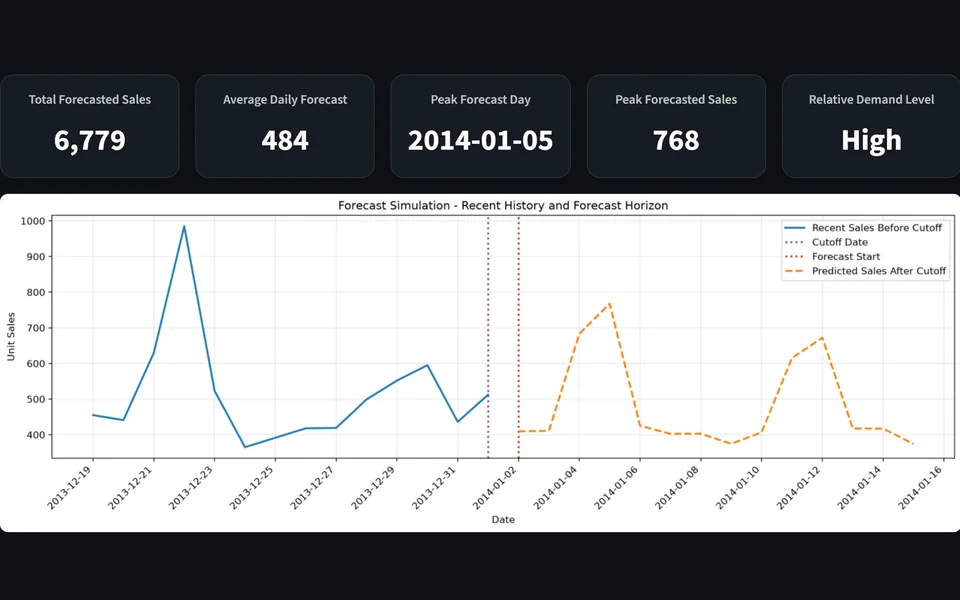
Screenshot der Streamlit-App FreshMart Demand Planner nach Generate forecast: fünf KPI-Kacheln (Gesamtprognose 6.779, Tagesdurchschnitt 484, Spitzentag 2014-01-05, Spitzenabsatz 768, Bedarfsniveau hoch) über einem Liniendiagramm mit Verkaufshistorie und 14-Tage-Prognose
Abb. 03Streamlit-App, Prognoseansicht · Aufnahme 03.09.2026

FreshMart Demand Planner

Absatzprognose für den Einzelhandel, End-to-End: EDA, Feature Engineering, Vergleich von 10+ Modellen (SARIMAX, Prophet, XGBoost, LSTM), HyperOpt-Tuning und MLflow-Experiment-Tracking. Deployed als Streamlit-Planungstool, das die Sprache der Filialleitung spricht: Gesamtbedarf, Spitzentag, Tagesdurchschnitt.

Champion-RMSE 138,0 MAE 93,1 Modelle 10+
PythonZeitreihenXGBoostMLflowStreamlit
Pos. 04 · Apr–Mai 2026
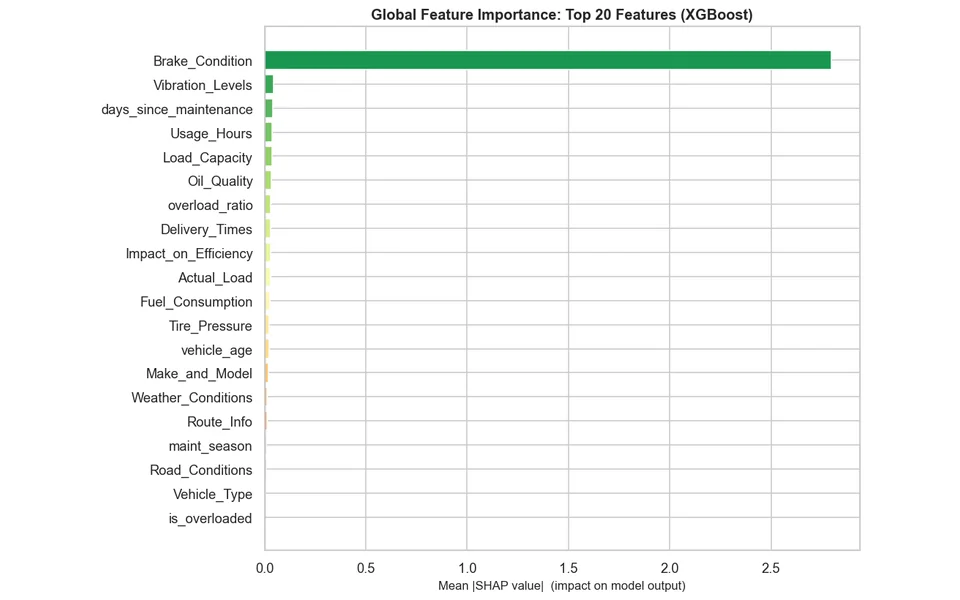
Horizontales Balkendiagramm der 20 wichtigsten Merkmale nach mittlerem |SHAP|-Wert; Brake_Condition dominiert mit rund 2,8, alle anderen Merkmale liegen unter 0,2
Abb. 04Mittlere |SHAP|-Merkmalswichtigkeit, XGBoost · Abbildung aus dem Repository

Predictive Maintenance: Flottenrisiko & Kosten

Drei Geschäftsfragen auf einem 92.000-Zeilen-Flottendatensatz: Welche Fahrzeuge brauchen Wartung (Klassifikation), was kostet sie (Regression), wie segmentiert man die Flotte nach Risiko (Clustering). Die SHAP-Analyse identifizierte Brake_Condition als dominanten Ausfallprädiktor, genau was 17 Jahre Fahrzeugentwicklung erwarten lassen.

PR-AUC 0,902 0,885 Zeilen 92T
PythonXGBoostSHAPSQLClustering
Pos. 05 · Jul 2026
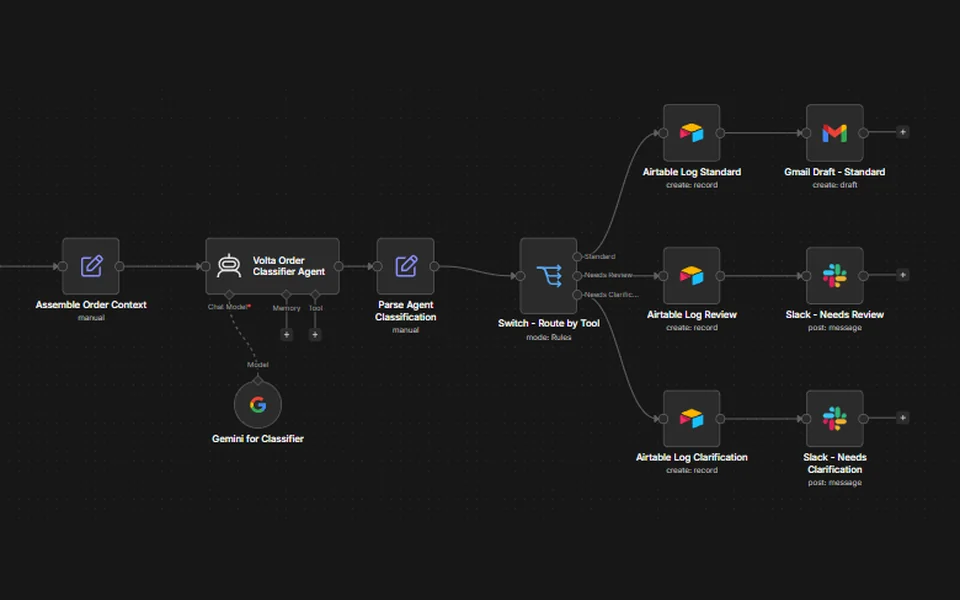
Ausschnitt des n8n-Canvas: Assemble Order Context, der Volta Order Classifier Agent mit Gemini als Modell, Parse Agent Classification, ein Switch mit den Routen Standard, Needs Review und Needs Clarification, jeder Zweig mit Airtable-Protokoll und Benachrichtigung per Gmail-Entwurf oder Slack
Abb. 05n8n-Workflow, Entscheidungszone · Screenshot aus dem Repository

KI-Auftragstriage

Ein n8n-Workflow mit 26 Nodes, der Freitext-Großhandelsbestellungen auf Englisch und Portugiesisch triagiert. Deterministische Airtable-Lookups sammeln zuerst jeden Fakt; ein begrenzter LLM-Agent trifft die eine Entscheidung, die sich nicht als Regel schreiben lässt; Logik routet und protokolliert jede Bestellung, und der Mensch bleibt der Absender: Der Workflow kontaktiert nie einen Kunden. Über je drei Durchläufe der zehn Beispielbestellungen stimmten alle 30 protokollierten Klassifikationen mit dem Referenz-Antwortschlüssel überein, und kein Input erhielt je zwei verschiedene Klassifikationen. Grundlage ist ein fiktiver Großhandelsfall, Volta Coffee Roasters in Porto.

Antwortschlüssel 30 / 30 KI-Schritte 2 von 8 Nodes 26
n8nGeminiAirtableSlackGmail API
Pos. 06 · Feb 2026 Live
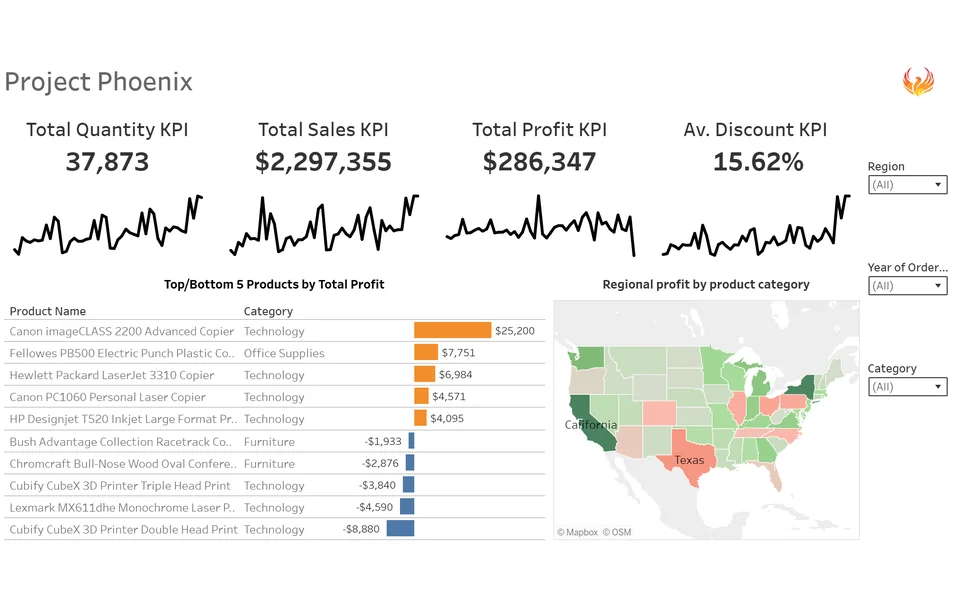
Screenshot des Retail KPI Dashboards auf Tableau Public: vier KPI-Kacheln mit Sparklines (Menge 37.873, Umsatz 2.297.355 Dollar, Gewinn 286.347 Dollar, mittlerer Rabatt 15,62 Prozent), eine Tabelle der fünf besten und schlechtesten Produkte nach Gewinn, eine US-Karte des regionalen Gewinns je Produktkategorie sowie Filter für Region, Jahr und Kategorie
Abb. 06Tableau Public, Main Dashboard · Aufnahme 03.09.2026

Retail-KPI-Dashboard

Interaktives Tableau-Dashboard für Umsatz, Gewinn, Rabatt und Bestellungen mit Drill-down nach Region, Produktkategorie und Zeitraum. LOD-Ausdrücke und Dashboard-Aktionen geben nicht-technischen Nutzern Self-Service-Analyse, dieselbe Logik wie eine Qualitäts-Trendtafel im Werk.

Zeilen ca. 10T Monate 48 Bundesstaaten 49
TableauLODDashboard-Aktionen
Pos. 07 · Jul–Aug 2026
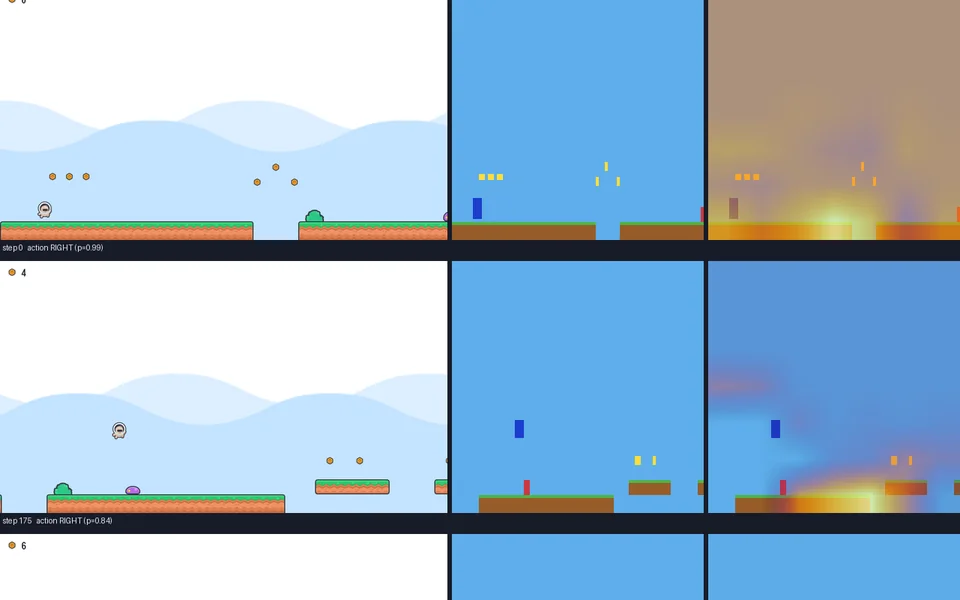
Zwei Reihen mit je drei Feldern: das gerenderte Level, der 84x84-Frame-Stack als CNN-Eingabe und die Grad-CAM-Aufmerksamkeitskarte, die Plattformkanten und Lücken hervorhebt
Abb. 07Grad-CAM-Salienz auf ungesehenen Levels · Abbildung aus dem Repository

Neuron Platformer RL

Reinforcement-Learning-Demos laufen meist in einer fertigen Umgebung, was die schwierigen Teile verdeckt: Belohnungsdesign, Beobachtungsdesign und die Frage, ob die Aufgabe überhaupt lösbar ist. Hier ist der gesamte Stack selbst gebaut, samt Levelgenerator, dessen Lücken durch die exakte Sprungphysik begrenzt sind, und einem Audit, das die Lösbarkeit über 1.200 Seeds neu beweist. Dann die eigentliche Frage: Ein Agent, der nur rohe 84x84-Pixel liest, ohne Koordinaten, Geschwindigkeiten oder Objektlisten, schlägt die handgebaute Zustandsvektor-Baseline bei gleichem Trainingsbudget mit 80 % zu 64 % auf 200 ungesehenen Levels, und ein Schwierigkeits-Curriculum bringt ihn auf 52 % (mittel) und 55 % (schwer). Grad-CAM zeigt, worauf er blickt: Plattformkanten vor dem Sprung, die Lücke, den Gegner. Eine vierte Phase ersetzt den Frame-Stack durch ein LSTM, das nur ein Bild pro Schritt liest: Rekurrenz lernt das Spiel, bleibt aber auf jeder Stufe hinter dem Frame-Stack - 29,5 % (mittel) gegen 52 % des Curriculums. Ehrliche Zahlen kosteten vier zusätzliche Experimente: Die Verdopplung des LSTM-Budgets widerlegte die eigene Ausrede des Textes (die typische Leistung stieg, die Spitze nicht), eine Rauschanalyse zeigte, dass eine Auswertung über 30 Episoden rund plus/minus 14 Punkte breit ist, und eine Neuvermessung aller vier Modelle auf 200 Seeds ersetzte jede Schlagzeilenzahl - die veröffentlichten 50 % der Baseline waren real 27 % - und eine Budget-Kontrolle einen Monat später zeigte, dass die Baseline mit einem Fünftel der Schritte des Pixel-Agenten trainiert war: bei gleichem Budget liest sie 64 %, und der Vorsprung schrumpfte von 53 auf 16 Punkte. Der Text wurde umgeschrieben statt beschönigt, zweimal.

Pixel-Agent 80 % Zustands-Baseline 64 % unmögliche Übergänge 0 von 11.619
PythonPyTorchStable-Baselines3GymnasiumGrad-CAM
Pos. 08 · Jul 2026
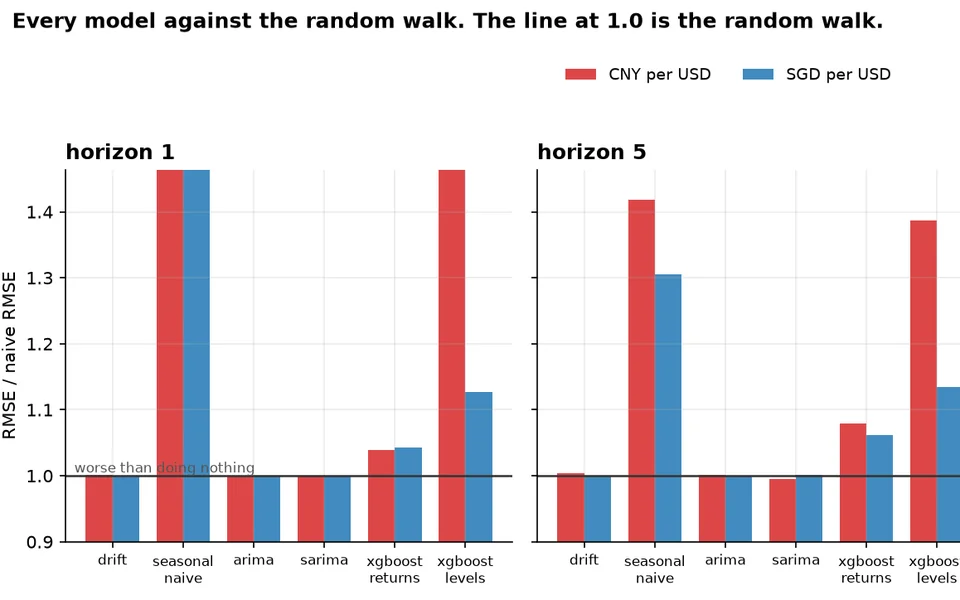
Balkendiagramm des RMSE jedes Modells geteilt durch den naiven RMSE für CNY und SGD je USD bei den Horizonten 1 und 5; die Linie bei 1,0 ist der Random Walk, kein Modell liegt darunter
Abb. 08RMSE-Verhältnis zum Random Walk, Horizonte 1 und 5 · Abbildung aus dem Repository

FX Random Walk Benchmark

Eine Bankaufgabe verlangte ein Modell zur Wechselkursprognose. Das Projekt stellte die Frage, die in der Aufgabe fehlte: verglichen womit? 20 Jahre Tageskurse SGD/USD und CNY/USD, zuerst die naive Basislinie "morgen gleich heute", danach ARIMA, SARIMA und Gradient Boosting gegen sie gemessen, über 42.924 Walk-Forward-Prognosen. Kein Modell schlug die Basislinie auf irgendeinem Signifikanzniveau, AIC wählte ARIMA(0,1,0), also den Zufallspfad selbst, und die eigens entwickelte Kennzahl move_ratio erklärt den Fehler jedes Modells mit r = 0,97. Die Leckagefreiheit ist keine Zusicherung, sondern ein maschineller Nachweis: Alle Beobachtungen nach dem Stichtag werden überschrieben, und die Merkmale davor müssen byte-identisch zurückkommen.

Walk-Forward-Prognosen 42.924 Modelle besser als naiv 0 Fehler erklärt r = 0,97
PythonstatsmodelsXGBoostDiebold-MarianoBacktesting
Pos. 09 · Mai 2026
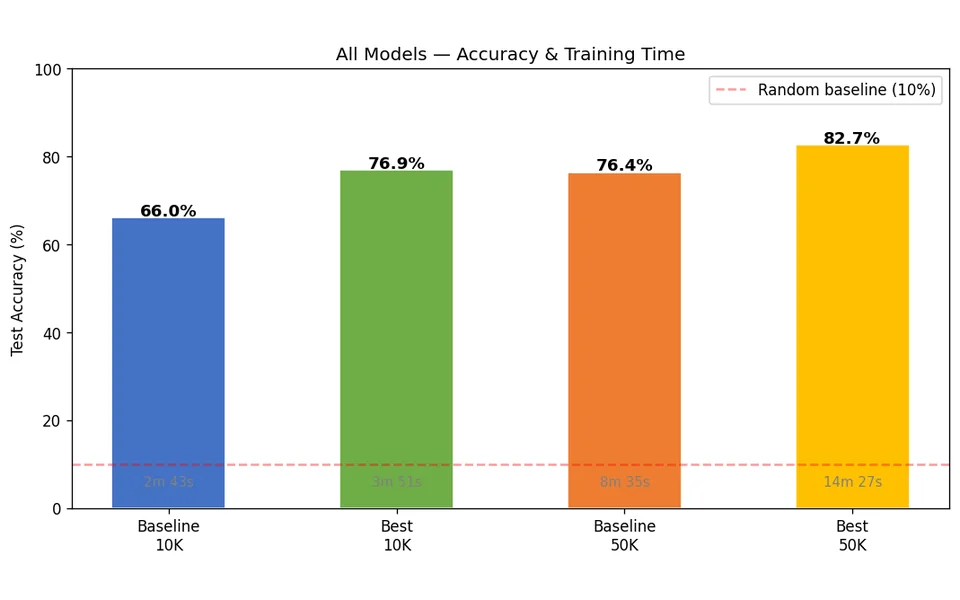
Balkendiagramm von vier Läufen: Baseline 10K 66,0 Prozent, Best 10K 76,9 Prozent, Baseline 50K 76,4 Prozent, Best 50K 82,7 Prozent, mit Trainingszeiten von 2 min 43 s bis 14 min 27 s und der Zufallsbasis von 10 Prozent als gestrichelte Linie
Abb. 09Ablation: Testgenauigkeit und Trainingszeit · Abbildung aus dem Repository

CIFAR-10 Transfer-Learning-Studie

Kontrollierte Ablationsstudie mit ResNet50: der isolierte Effekt von Datenmenge, Augmentierung, Learning-Rate-Scheduling und partiellem Unfreezing, einzeln und kombiniert getestet. Grad-CAM-Visualisierungen zeigen, worauf das Modell tatsächlich achtet. Derselbe Mechanismus treibt die automatisierte Sichtprüfung in der Fertigung.

Accuracy 66 % → 82,7 % Bilder 60T
TensorFlowKerasResNet50GradCAM
Pos. 10 · Jun 2026
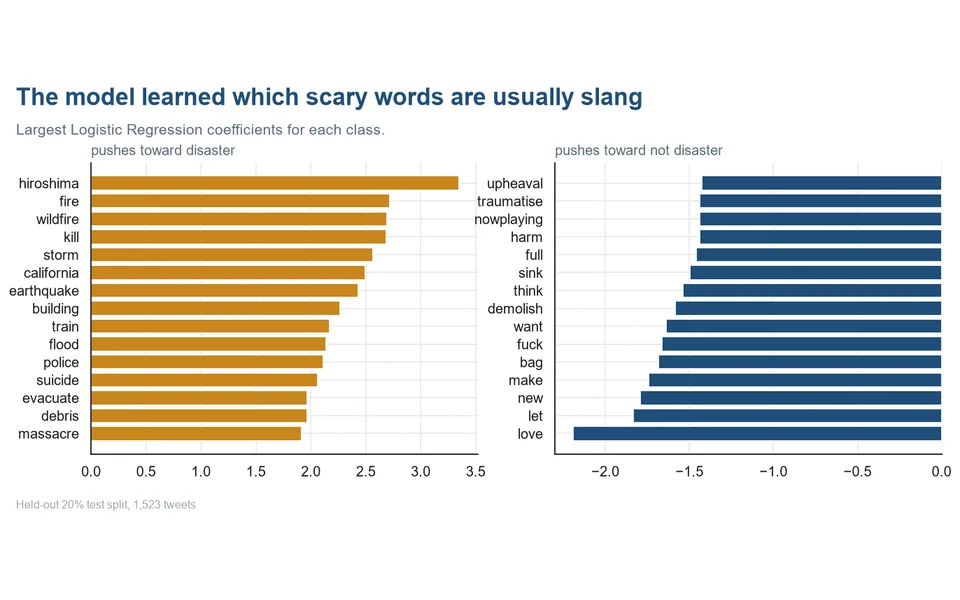
Zwei Balkendiagramme der abgestimmten logistischen Regression: Wörter, die zu Katastrophe tendieren (hiroshima, fire, wildfire, kill, storm), und Wörter, die zu Nicht-Katastrophe tendieren (upheaval, traumatise, love); Testsplit mit 1.523 Tweets
Abb. 10Größte Koeffizienten der logistischen Regression · Abbildung aus dem Repository

NLP: Disaster-Tweets-Klassifikation

Meldet ein Tweet eine echte Katastrophe, oder ist "this album is fire" nur Slang? Ausgeliefert wurde ein interpretierbarer TF-IDF + Logistic-Regression-Klassifikator, getestet gegen ein CNN from scratch und ein feinjustiertes DistilBERT. Das erklärbare Modell gewann die Abwägung: Jede Markierung lässt sich Wort für Wort begründen, und das zählt mehr als die letzten zwei Punkte Accuracy.

Accuracy 0,819 Kaggle public 0,791 DistilBERT-Benchmark 0,839
Pythonscikit-learnNLTKPyTorchDistilBERT
Pos. 11 · Jul 2026
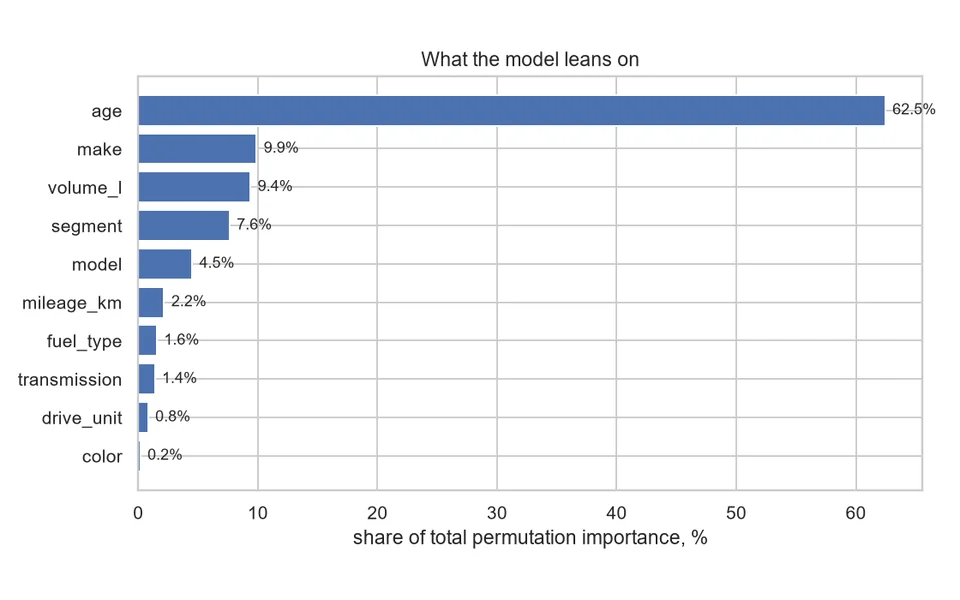
Horizontales Balkendiagramm mit dem Titel What the model leans on: Anteil an der gesamten Permutations-Importance je Merkmal, Alter 62,5 Prozent, Marke 9,9, Hubraum 9,4, Segment 7,6, Modell 4,5, Laufleistung 2,2, Kraftstoff 1,6, Getriebe 1,4, Antrieb 0,8, Farbe 0,2
Abb. 11Permutations-Importance je Merkmal · Abbildung aus dem Repository

Car Price Estimator

Ein Preistool, das eine kalibrierte Preisspanne statt einer einzelnen Zahl liefert, gebaut auf 56.244 Gebrauchtwagen-Inseraten. Zwei der drei geforderten Modellfamilien verloren gegen eine Nachschlagetabelle, wie ein Händler sie im Kopf hat; XGBoost gewann, und der echte Vorsprung liegt bei Autos, die die Tabelle nie gesehen hat: 46 % besser. Der Befund, über den man nach 17 Jahren Automobilbranche streiten möchte: Der Kilometerstand sagt den Preis kaum voraus, sobald das Alter bekannt ist, mit 2,2 % Permutations-Importance gegen 62,5 % für das Alter.

Medianfehler 11,9 % Lookup-Baseline 13,3 % MAE 1.016 $
PythonpandasXGBoostConformal Prediction
Pos. 12 · Jul 2026
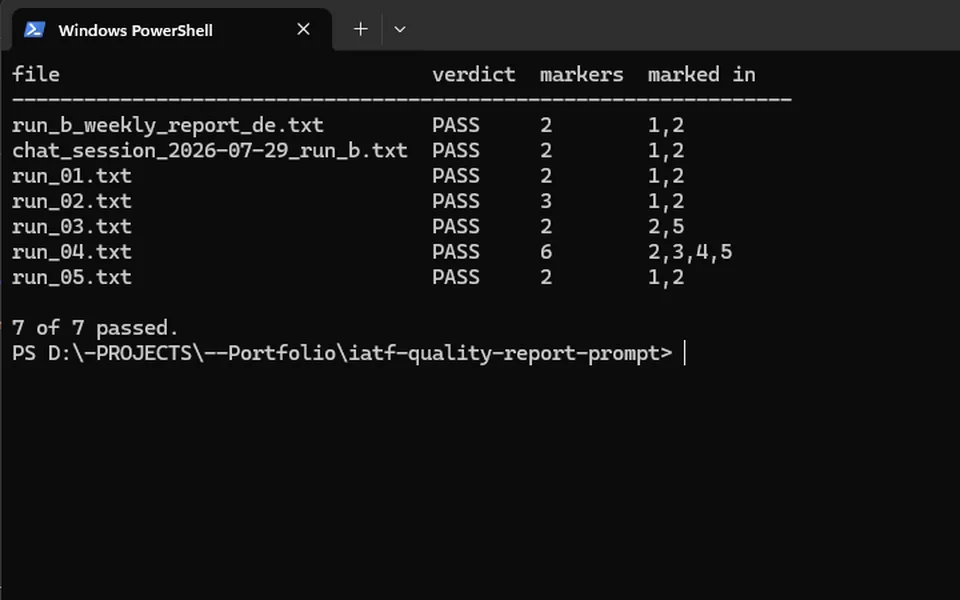
PowerShell-Fenster mit sieben Berichtsdateien, jede mit Urteil PASS, der Zahl der gefundenen Lückenmarker und den markierten Abschnitten, abgeschlossen mit 7 of 7 passed
Abb. 12Lauf des Marker-Checkers, 7 von 7 bestanden · Screenshot aus dem Repository

IATF Quality Report Prompt

Kann man einem Sprachmodell verbieten, eine Lücke in einer gelenkten Aufzeichnung zu füllen? Ein Drei-Zonen-Prompt entwirft deutsche Qualitätsberichte nach ISO 9001 / IATF 16949 und darf keine Zahl ableiten, die nicht in den Daten steht: In einer QMS-Aufzeichnung ist eine abgeleitete Zahl eine Audit-Feststellung, auch wenn sie rechnerisch stimmt. Ein Negativkontrolltest hielt eine Zahl zurück und ließ beide Operanden als Köder stehen. Kein Lauf hat sie berechnet; die Lückenmarkierung erschien nur in 5 von 7 Läufen an beiden geforderten Stellen, und diese schwächere Zahl ist veröffentlicht wie gemessen, der Prompt bewusst nicht nachgebessert.

ohne erfundene Zahlen 7 von 7 Läufen Lücke doppelt markiert 5 von 7 eigene Defekte veröffentlicht 3
Claude Opus 5Prompt EngineeringTestdesignPython
Pos. 13 · Mär–Apr 2026
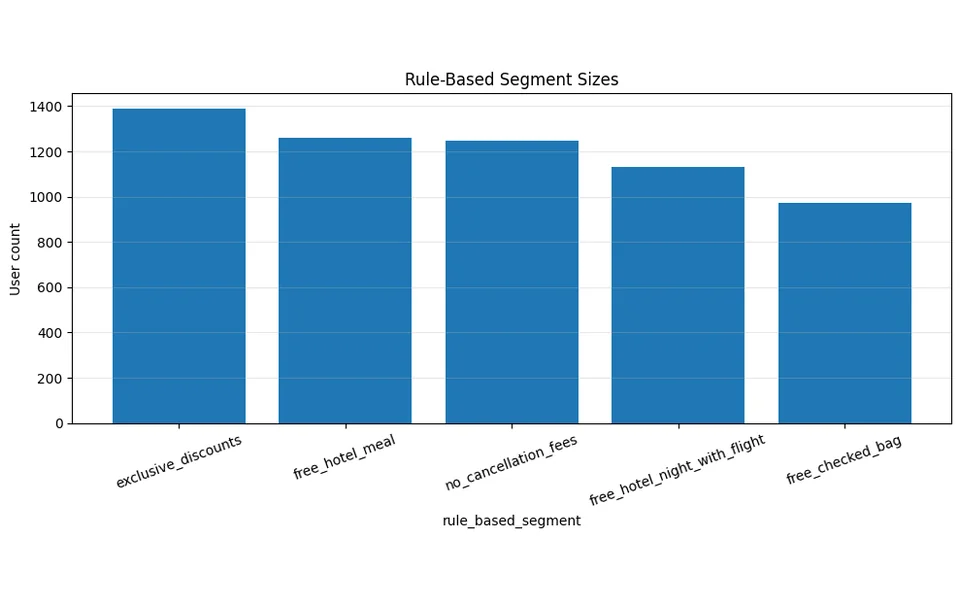
Balkendiagramm der Nutzerzahl je regelbasiertem Segment: exclusive discounts rund 1.390, free hotel meal rund 1.260, no cancellation fees rund 1.250, free hotel night with flight rund 1.130, free checked bag rund 970
Abb. 13Größe der regelbasierten Segmente · Notebook-Ausgabe

TravelTide: Kundensegmentierung

Retention-Targeting für eine Reiseplattform: Eine SQL-Pipeline in Databricks aggregierte 49.211 Sessions zu 30+ Verhaltensmerkmalen für 5.998 Nutzer; ein regelbasierter Perk-Fit-Score ordnete jedem Nutzer die relevanteste Belohnung zu. K-Means und DBSCAN dienten als Benchmark; der interpretierbare Ansatz gewann bei Stabilität und Deployment-Reife.

Nutzer 5.998 Segmente 5 ausgewogen Merkmale 30+
SQLSparkSQLDatabricksPython

Weitere Projekte und Work in Progress auf GitHub und Tableau Public.

Die Geschichte hinter den Projekten?

17 Jahre Automobil-Engineering prägen, wie ich jeden Datensatz angehe: erst die Ursache, dann der Geschäftsnutzen, dann das Tooling.

Kennzahlen reproduzierbaraus den verlinkten Repositories