02 Projekte / Arbeitsplan PS-03
KI-Agentensystem (AI-Brain)
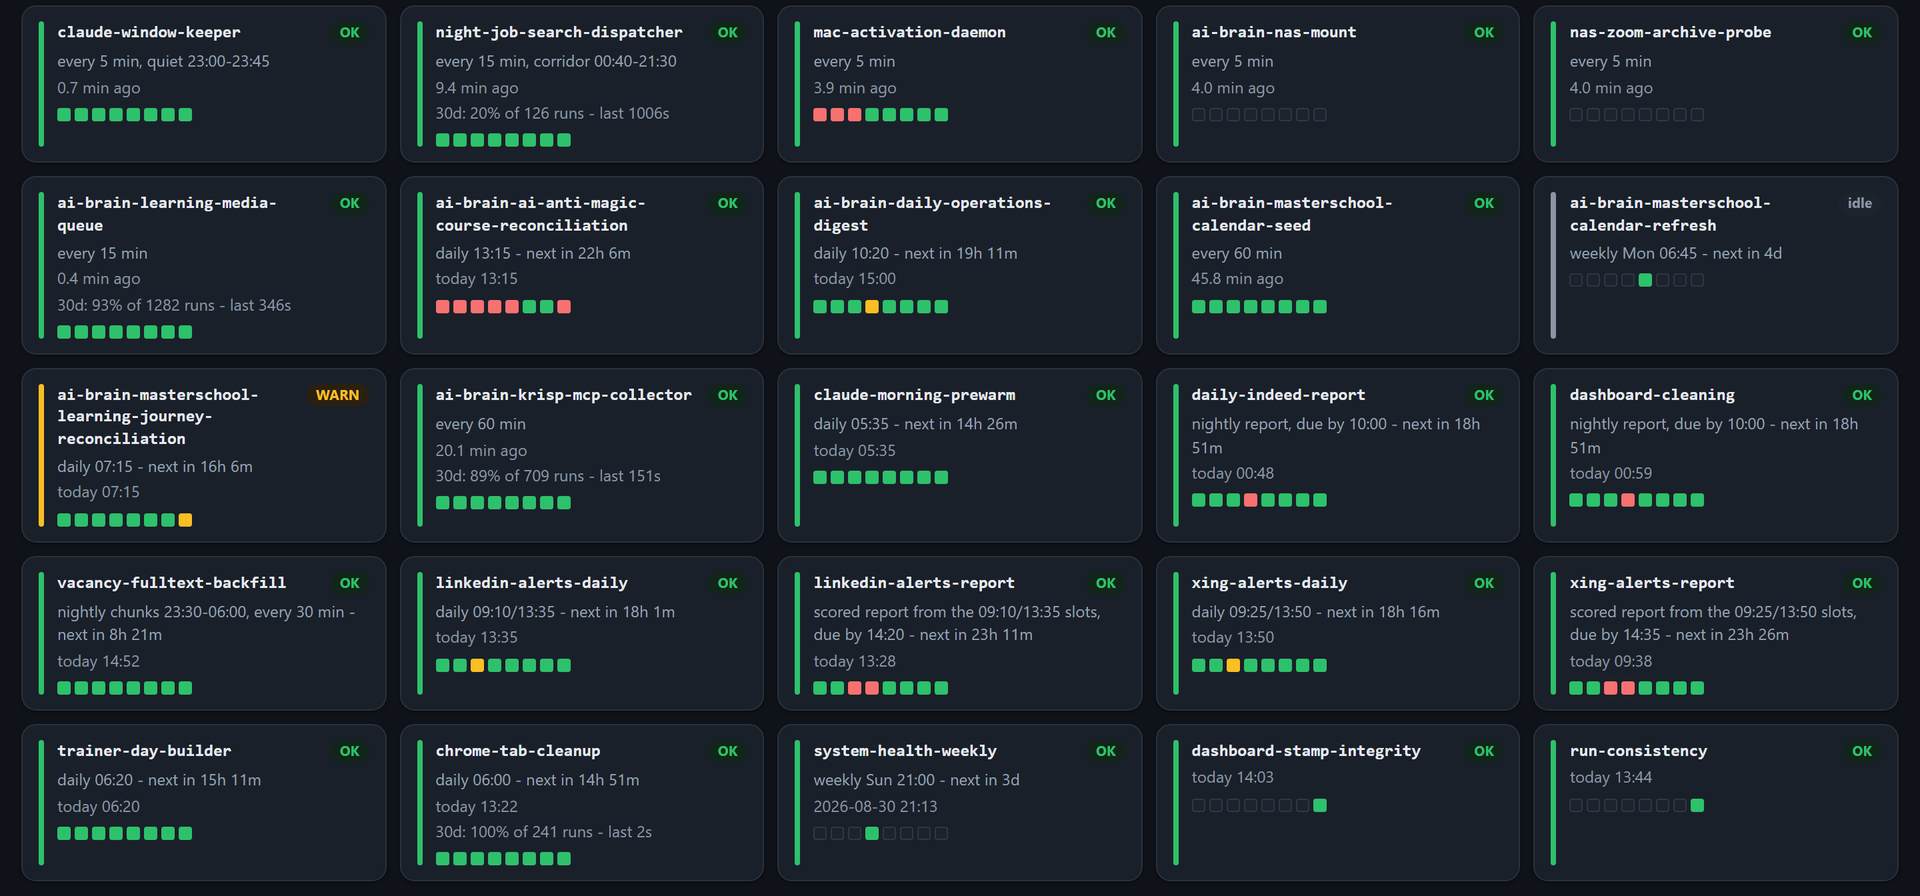
Ein privates Multi-Agenten-System im täglichen Betrieb: 19 wiederkehrende Workflows mit je genau einem geplanten Owner, ausgeführt von drei LLM-Laufzeitumgebungen und einem selbst gehosteten n8n-Server auf einem einzigen Markdown-Regelwerk, verteilt auf zwei bewusst unabhängige Rechner.
Zweck & Umfang
Die Frage ist nicht, ob ein Agent das kann
Eine Jobsuche, ein Vollzeit-Datenprogramm und mehrere private Verwaltungsbereiche erzeugen immer dieselbe Art wiederkehrender Arbeit: aus einer Quelle sammeln, gegen die Historie entdoppeln, jeden Eintrag bewerten, das Ergebnis in die richtige Datei schreiben, zwischen den Sitzungen nichts verlieren. Von Hand skaliert das nicht. Einem Chat-Assistenten alles zu überlassen scheitert anders, denn er hat kein Gedächtnis zwischen Sitzungen, wiederholt bereits erledigte Arbeit und liefert lieber eine plausible Antwort, als zu melden, dass er keine bekommen hat. Die Entwurfsfrage war deshalb immer die andere: Wie verhindert man, dass er unbemerkt das Falsche tut? Daraus besteht der größte Teil dieses Systems.
Arbeitsfolge · Routing
Sechs Entwurfsentscheidungen, in der Reihenfolge ihrer Bedeutung
Jede Zeile ist eine Regel, die zuerst aufgeschrieben und danach durchgesetzt wurde. Die Architektur ist das Ergebnis, nicht der Code.
| Op. | Entscheidung | Was sie verhindert |
|---|---|---|
| 10 | Regeln liegen in einfachem Markdown | Jeder Agent, jeder Anbieter liest zum Sitzungsstart dieselben kanonischen Dateien. Kein Workflow hängt an einem Hersteller |
| 20 | Genau ein geplanter Owner je Workflow | Mehrere Agenten schreiben dieselben Dateien ohne Datenbanksperre. Die Ownership verhindert, dass zwei Läufe zwei widersprüchliche Fassungen eines Berichts erzeugen |
| 30 | Deterministische Schicht unter der semantischen | Python übernimmt Abruf, Parsing, Entdopplung und Schreiben; das Modell bekommt nur die Bewertung, die wirklich Bewertung erfordert |
| 40 | Begrenzte Agenten | Der Agent erhält die Fakten deterministisch und entscheidet innerhalb einer festgelegten Optionsmenge, statt Fakten zu suchen und zugleich zu entscheiden |
| 50 | Gates, die den Lauf scheitern lassen können | Ein Ergebnis gilt nicht als richtig, weil ein Agent es behauptet. Ein Lauf ist fertig, wenn die Prüfungen bestehen |
| 60 | Watchdog auf einem unabhängigen Rechner | Ein Watchdog, der gemeinsam mit dem überwachten System ausfällt, meldet genau dann nichts, wenn es darauf ankommt |
Messwerte · Aus dem System selbst zählbar
Was tatsächlich läuft
Was die fünf Gates prüfen
Dass jede in einem Bericht behauptete Kennung in Registry und Archiv existiert. Dass keine Zeichensatz-Korruption ausgeliefert wurde. Dass ein erzeugtes PDF maschinenlesbar und in der richtigen Lesereihenfolge ist. Dass kein Dokument eine Kompetenz behauptet, die die Quelldatei nicht führt. Dass der Text nicht nach Vorlage klingt.
Wo die Entscheidung beim Menschen bleibt
Nichts wird von einem Agenten versendet, eingereicht oder veröffentlicht. Das System bereitet vor, prüft und dokumentiert; die Entscheidungen, die andere Menschen erreichen, bleiben meine. Diese Grenze ist eine Regel im selben Markdown, das die Agenten lesen, keine Gewohnheit.
Abweichungen · Im Betrieb gefunden
Die Fehlerbilder sind das eigentliche Ergebnis
Keines davon stammt aus der Literatur. Jedes wurde im Betrieb gefunden und danach so in die Regeln geschrieben, dass es nicht unbemerkt wiederkehren kann.
| Nr. | Fehlerbild | Abstellmaßnahme |
|---|---|---|
| 01 | Erfundene Kennzahlen | Ein Assistent erzeugte konkrete, selbstbewusst formulierte, bezifferte Erfolge, die es nie gab, und bot sie als Interviewmaterial an. Regel: eine Zahl ist nur verwendbar, wenn sie in der Quelldatei steht. Gate: jede Angabe mit einer Einheit markieren, die dort nirgends vorkommt. Konkretheit ist das Erscheinungsbild einer erfundenen Kennzahl, kein Gegenbeweis. |
| 02 | Echo der Quelle | Ein schreibender Agent übernimmt das Vokabular des Ausgangsdokuments in die Beschreibung der Person. Vier Dokumente gingen so hinaus, bevor es ein eigenes Inhalts-Gate gab; die schärfste Prüfung ist dreiseitig und findet Begriffe, die im Entwurf und in der Quelle stehen, in der Stammdatei aber fehlen |
| 03 | Nicht das Substantiv wird aufgewertet, sondern das Verb | Eine dokumentierte Methode, formuliert als "von mir geführte Untersuchungen", besteht jede Begriffsprüfung, denn die Gates prüfen Begriffe und die Behauptung steckt im Verb. Kein automatischer Check erkennt diese Klasse. Sie ist als benannte Grenze festgehalten, nicht als gelöstes Problem |
| 04 | Stiller Scheduler-Ausfall | Ein toter Scheduler und ein gesunder Rechner ohne Netz erzeugen dasselbe Signal. Der Heartbeat muss beide unterscheiden, statt auf Veralterung zu alarmieren, sonst gewöhnt man sich das Wegsehen an |
Abnahme · Benannte Grenzen
Was ich behaupte, und was nicht
Die ehrliche Grenze
Ich habe dieses System entworfen, spezifiziert und betreibe es: Architektur, Ownership-Modell, Regeln, Gates und die Diagnose sämtlicher oben genannter Fehlerbilder stammen von mir. Der Code entstand weitgehend KI-gestützt und wurde nicht von Grund auf getippt. Zu behaupten, ich hätte gut hundert Skripte entwickelt, wäre falsch und würde in der ersten technischen Rückfrage zusammenbrechen. Für eine Aufgabe, in der es darum geht, KI für andere nutzbar zu machen, ist die genaue Aussage zugleich die stärkere.
Warum es kein Repository gibt
Das System betreibt einen privaten Wissensspeicher mit persönlichen und bewerbungsbezogenen Daten, wird also nicht veröffentlicht und bleibt es auch. Live vorführbar ist es per Bildschirmfreigabe: die Workflow-Registry, die datierte Ausgabe eines geplanten Laufs, die Gate-Skripte und ihr Bestanden oder Nicht-bestanden. Die Zahlen auf dieser Seite sind aus dem System selbst zählbar und verändern sich, wenn es wächst.
Interessant sind die Leitplanken.
Wer selbst Agenten baut, stellt zuerst dieselbe Frage: Wie verhindert man, dass das System unbemerkt das Falsche tut? Genau darüber spreche ich lieber, und genau das kann ich im Betrieb zeigen.